AI KID
 RE/MAX Patagon
 Mateo Caño
En esta guía
#¿Qué significa evaluar un brief SEO, y por qué no es lo mismo que evaluar la skill
Cuando alguien dice "evaluamos nuestra skill de Claude Code" casi siempre se refiere a evaluar el código: si el trigger dispara en el momento correcto, si el sub-agente ejecuta bien los pasos, si no rompió nada de una versión a otra. Eso es necesario, pero es una capa distinta de evaluar el artefacto de contenido que esa skill produce antes de que un humano (o el mismo modelo) se ponga a redactar el artículo final.
Un brief SEO es esa pieza intermedia: el documento que junta intención de búsqueda, gap de contenido, competidores, subtemas obligatorios y la fuente de cada dato, antes de escribir una sola oración del artículo. Si el brief está mal (un gap inventado, una fuente no citada, un research de hace dos meses) todo lo que se escribe encima hereda ese error, sin importar cuán bien redactada quede la prosa. Evaluar la skill de código y evaluar el brief que esa skill entrega son dos gates distintos, y hoy casi nadie documenta el segundo.
Ver cómo aplicar esta guía a mi marca
#El gap: 5 recursos evalúan la skill, ninguno evalúa el brief que produce
Repasamos los recursos más citados sobre evals de skills de Claude Code: el skill-creator 2.0 de Anthropic con sus sub-agentes executor/grader/comparator/analyzer (tessl.io), el experimento de dbt con una rúbrica LLM-judge de 9 criterios (rmoff.net), el A/B testing con una confianza por encima de 0,90 sobre 50 o más ejemplos (MindStudio) y la librería de marketing skills de Ahrefs (ahrefs.com).
Los cuatro evalúan el proceso o el código de la skill. Ninguno define cómo evaluar el artefacto de contenido SEO que esa skill produce antes de redactar: ni fijan un umbral pass/fail para un brief editorial, ni aplican su metodología a contenido de marketing escrito. Ese es el hueco puntual que este gate cubre, no un "los demás no son lo bastante completos" genérico: cada fuente tiene una carencia específica y citable, no una queja vaga.
#Qué distingue un content gap específico y verificable (con evidencia y URL) de una queja genérica de tipo 'los competidores no son lo bastante completos'
La diferencia no es de tono, es de verificabilidad. "Los competidores no son lo bastante completos" no se puede confirmar ni refutar: es una opinión. Un gap específico cita, por cada competidor relevado, qué cubre (coverage) y qué le falta (missing) con el sourceUrl de esa página, de forma que cualquier tercero pueda entrar al link y comprobar la afirmación en un minuto. En este gate, el hard check gap bloquea directamente cualquier brief donde el statement no venga acompañado de al menos una evidencia con claim y URL válida: sin URL, no es gap, es queja.
#Judges basados en reglas (hard checks) vs LLM-judge
Un score total de 90 sobre 100 puede esconder un eje en 8 sobre 20 (por ejemplo, evidencia sin URLs reales). El promedio tapa el problema y el brief pasa igual.
Los hard checks (deterministas, gratis, corren en milisegundos) filtran primero lo objetivo. Recién si pasan, el LLM-judge puntúa 5 ejes semánticos y cada uno tiene que superar su propio piso, sin importar el promedio.
Los hard checks son código puro: sin placeholders, research con menos de 14 días, un interlink con motivo, fuentes declaradas. Corren en milisegundos y siempre dan el mismo resultado. El LLM-judge entra después, para lo que el código no puede medir solo: si el gap es específico o genérico, si el unique take tiene prueba real o es una afirmación de marketing. Tratarlos como el mismo paso es el error más común.
| Tipo de evaluación | Qué comprueba | Resultado |
|---|---|---|
| Hard check | Campos, URLs, fechas, cantidades y placeholders | Pass o fail determinista |
| LLM-judge | Especificidad, evidencia, utilidad y coherencia editorial | Puntaje por eje con piso mínimo |
| Revisión humana | Riesgo de marca y excepciones no previstas | Aprobación solo cuando hace falta |
Este mismo principio (un blocker no se promedia, se resuelve puntual) aparece también en harnesses de evals de skills que auditan código en vez de contenido: el harness j-rig-skill-binary-eval evalúa en siete capas (entre ellas integridad del paquete, calidad del trigger y decisión de rollout) con criterios binarios, y aclara que un blocker no se puede compensar con el promedio. La diferencia con el gate de este artículo es el objeto que audita cada uno: j-rig audita el código y los triggers de la skill, este gate audita el brief editorial que esa skill produce antes de redactar.
#Estructura de evals.json / test cases con assertions verificables
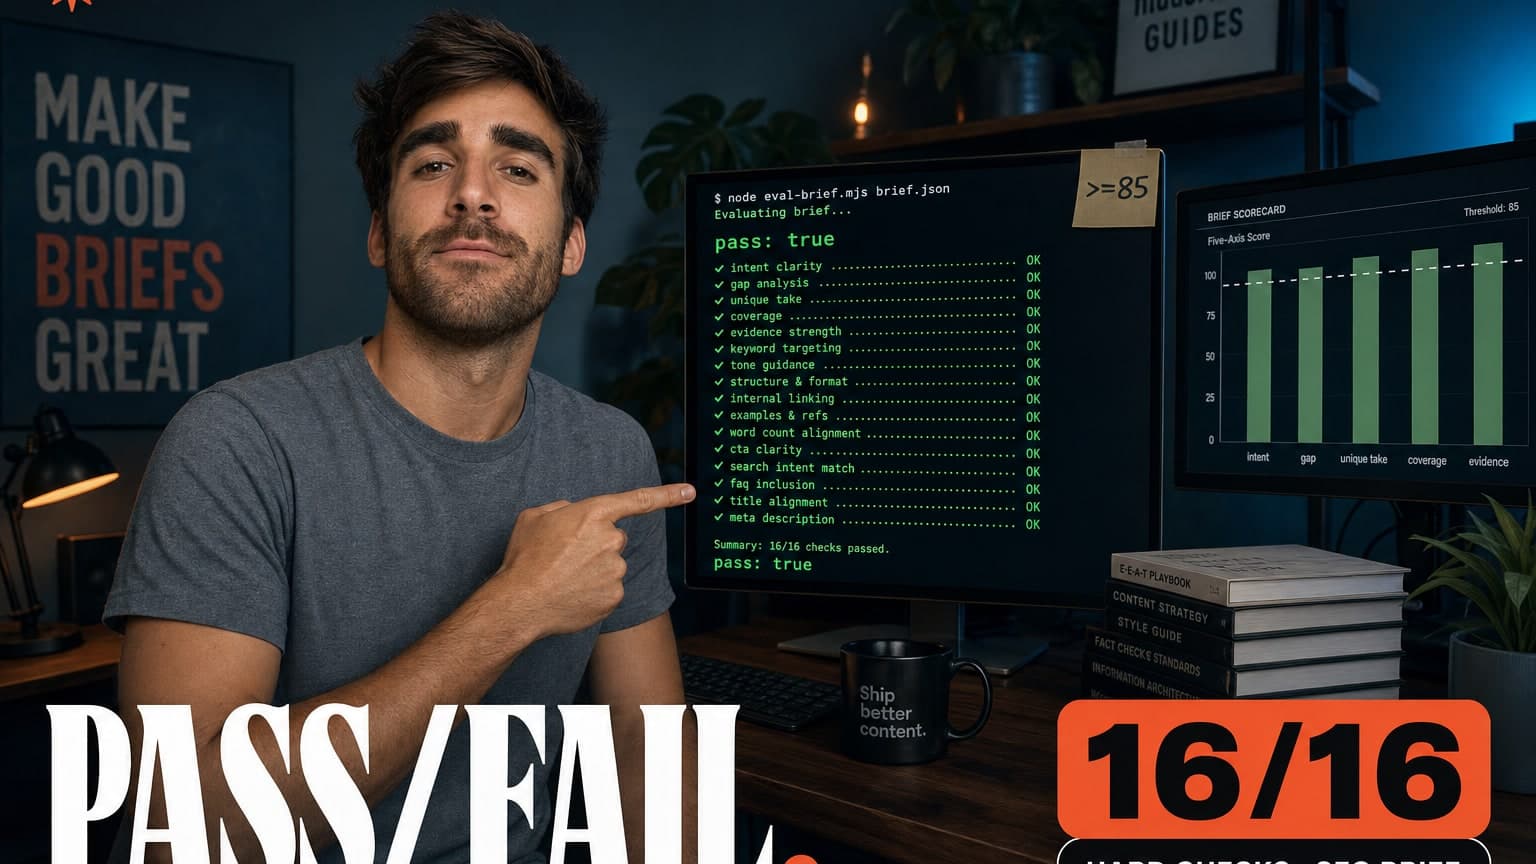
Este gate no usa un evals.json de skill genérico: usa un script propio, eval-brief.mjs, que corre 16 checks binarios sobre el objeto JSON del brief. La lógica es la misma que describe el skill-creator de Anthropic (assertions binarias, deterministas, sin escala de "más o menos"), aplicada al objeto de contenido en vez de al código:
// cada check devuelve { id, pass, message }, sin promedios ni escalas
add("freshness", ageMs <= 14 * 86_400_000, "research debe tener <=14 días")
add("gap", statement.length >= 40 && evidence.every(hasUrl), "gap exige evidencia con URL")
add("interlinks", interlinks.length >= 1 && interlinks.every(hasReason), "al menos un interlink con motivo")
Si un solo check falla, el brief entero queda en blockers con el id y el mensaje exacto de qué corregir. No hay "aprobado con observaciones": o los 16 pasan, o el brief no avanza a la siguiente capa.
#Checklist de implementación paso a paso: cómo montar hard checks estructurales + un rubric de 5 ejes con piso por dimensión sobre tu propio brief SEO
- Escribí los hard checks primero. Empezá por lo verificable sin ambigüedad: schema válido, cero placeholders, research con fecha y antigüedad máxima, cada competidor con
coverageymissing, cada fuente (GSC, Ahrefs) con un estado declarado. - Corré el script y mirá el output real, no confíes en que "debería pasar":
- Epass: true
- TbriefHash: 1f16cad5...8891ef
- Achecks: 16/16 · blockers: []
- Probá que el piso bloquea de verdad, no solo que aprueba. Corré el mismo fixture con el gap invalidado (statement placeholder, evidencia vacía) y confirmá que el script lo rechaza con el
idexacto del check que falló:
- Epass: false
- Tblockers: placeholders, gap
- AbriefHash: faa10fb8...59b499
- Sumá el rubric semántico recién si los hard checks pasan. 5 ejes (intent_format, content_gap, unique_take, coverage, evidence), cada uno puntuado 0 a 20 por un LLM-judge, con un piso de 16 por eje sobre un total mínimo de 85.
- Versioná un test suite con fixtures good/bad (
eval-brief.test.mjs) para que cada cambio al script se valide contra casos conocidos antes de tocar producción. - Conectá el gate al pipeline: el redactor (la skill que escribe el artículo) recibe el brief solo si
pass: true, y verifica que elbriefHashque recibió coincide con el que evaluó el gate, para no redactar sobre una versión vieja o alterada del brief.
#Umbral de pass/fail y blockers accionables para un gate editorial
Un blocker sirve si le dice al que repara exactamente qué tocar, no "el brief necesita mejorar". Cada check de eval-brief.mjs devuelve un id (gap, interlinks, freshness) y un mensaje puntual ("gap exige statement específico y evidencia con URL"). El rubric semántico suma un piso de 16 sobre 20 por eje y un total mínimo de 85 sobre 100, de modo que ningún eje puede quedar débil aunque el promedio general apruebe: un brief con evidencia en 19 pero unique take en 10 no pasa, aunque el promedio dé 14.5 sobre 20 en esos dos ejes.
#Cómo mitigar la varianza entre corridas de un LLM-judge (multi-sample voting, calibración, umbral de desacuerdo) antes de fijarlo como gate pass/fail
Ningún LLM-judge da exactamente el mismo score en dos corridas separadas. Una forma directa de no depender de una sola pasada es el multi-sample voting: correr el mismo brief contra el judge 3 o 5 veces y quedarte con la mediana, o exigir mayoría de acuerdo antes de tratar el veredicto como definitivo; si el desacuerdo entre corridas supera un umbral fijo, el brief va a revisión humana en vez de resolverse solo. La otra pata es tratar el resultado como un test compuesto: combinar los 5 ejes en vez de un score único, exigir que cada uno supere su piso de forma independiente, y calibrar el juez cada tanto comparando su veredicto contra criterio humano. El estudio de dbt de rmoff.net es honesto sobre esto: reconoce la varianza entre jueces sin resolverla del todo, y concluye textualmente que "ninguno de los tests produjo un proyecto de dbt lo bastante bueno para llevar a producción", y que Claude Code sigue necesitando a alguien con experiencia que lo guíe y revise. Ese hallazgo aplica igual acá: el gate automático reduce el volumen de revisión humana, no la elimina.
#Riesgo de falsos positivos (bloquear un brief válido) y costo de mantenimiento de un gate semántico automático: cómo mitigarlo sin bajar el umbral de aprobación
Un gate mal calibrado castiga briefs válidos por detalles menores. La forma de evitarlo sin bajar el umbral es acotar el rubric a 5 ejes con criterios claros, puntuados por separado para que uno no contamine a los otros, fijar el piso por eje en un número bajo pero real (16 sobre 20, no 19) y versionar un test suite de fixtures conocidos que corra cada vez que se toca el script. Si el test suite sigue devolviendo pass: true en el fixture bueno y pass: false en el malo después de un cambio, el gate sigue calibrado. Si empieza a fallar el fixture bueno, el problema es el gate, no el brief.
#Declarar fuentes GSC/Ahrefs como used/unavailable/not_applicable sin inventar datos
Cada fuente externa (Google Search Console, Ahrefs) se declara con un estado: used si hay datos reales con fecha de consulta, unavailable si la integración no está instalada, not_applicable si no corresponde al caso. Nunca se rellena con un número estimado que parezca real. El hard check source_gsc / source_ahrefs bloquea cualquier brief que no declare esto explícitamente, así el gate impide tanto inventar datos como esconder que faltan.
#Integración del gate de evals en el pipeline editorial antes de publicar
El orden importa: research → brief → gate (hard checks + rubric) → redacción → eval del artículo final contra el mismo briefHash. Si el redactor recibe un brief sin pass: true o con un briefHash que no coincide con el que evaluó el gate, el paso correcto es detenerse y devolver el brief a reparación, no completar los huecos por su cuenta. Esa frontera (quién repara el brief vs. quién redacta encima) es la que evita que un modelo termine aprobando su propio trabajo sin evidencia verificable.
#Cómo aplicar esto hoy
- Definí primero los hard checks que tu brief necesita (schema, placeholders, antigüedad de research, fuentes declaradas) y escribilos como funciones puras que devuelvan
{ id, pass, message }. - Corré el script contra un brief real y contra una variante rota a propósito, para confirmar que el piso bloquea y no solo aprueba.
- Sumá el rubric semántico con piso por eje recién cuando los hard checks ya pasan, nunca antes.
- Versioná el test suite (fixtures good/bad) junto al script del gate.
- Conectá el gate al pipeline para que el paso de redacción verifique
pass: truey elbriefHashantes de escribir una línea.
#Links útiles
- Catálogo evaluado de skills de Claude: 50 Claude Skills 2026
- Selección de skills recomendadas: Las mejores Claude Skills 2026
- Guía de Higgsfield conectado a Claude por MCP: Higgsfield + Claude para generar videos de campañas
- Skill-creator 2.0 de Anthropic: tessl.io
- Eval de dbt desde cero: rmoff.net
- A/B testing de skills: MindStudio
- Claude Skills para SEO y marketing: Ahrefs
- Harness binario de evals para skills (código, no contenido): j-rig-skill-binary-eval
- Misma regla de "no sé" aplicada a instrucciones personalizadas de ChatGPT: cómo hacer que ChatGPT deje de mentirte
Quiero aplicar a mi caso la guía "Cómo evaluar skills SEO de Claude Code con evals automáticos" de Claura.
Guía: https://claura-ai.com/resources/como-evaluar-skills-claude-code-seo-evals-automaticos

Mi caso: [a qué me dedico, qué herramientas uso y qué quiero lograr]

La guía cubre:
- ¿Qué significa evaluar un brief SEO, y por qué no es lo mismo que evaluar la skill
- El gap: 5 recursos evalúan la skill, ninguno evalúa el brief que produce
- Qué distingue un content gap específico y verificable (con evidencia y URL) de una queja genérica de tipo…
- Judges basados en reglas (hard checks) vs LLM-judge
- Estructura de evals.json / test cases con assertions verificables
- Checklist de implementación paso a paso
- Umbral de pass/fail y blockers accionables para un gate editorial
- Cómo mitigar la varianza entre corridas de un LLM-judge (multi-sample voting, calibración, umbral de…

Lee la guía (si no puedes abrir el link, trabaja con los temas de arriba). Si te falta información sobre mi caso, hazme hasta 3 preguntas antes de empezar. Después arma un plan para aplicar la guía paso a paso a mi caso y dime qué puedo hacer hoy en menos de una hora.
Cópialo y pégalo en tu agente: te pregunta lo que le falta de tu caso y arma el plan con los pasos de esta guía. ¿Prefieres que lo armemos nosotros? Agenda una llamada.
 También te puede interesar50 Claude skills 2026 · de diseño, código y marketing por categoría
?Preguntas frecuentes sobre Evals de skills Claude
¿Cómo se estructura un archivo evals.json con test cases y assertions verificables para una skill de Claude Code?
Un evals.json vive adentro de la carpeta de la skill y guarda test cases: cada uno define un input (prompt o archivo de entrada) y una o más assertions binarias que evalúan a pass o fail, sin escalas de "más o menos bien". El skill-creator 2.0 de Anthropic corre estos casos con sub-agentes executor, grader, comparator y analyzer en paralelo, en 4 modos (Create, Eval, Improve, Benchmark). Para una primera señal, MindStudio sugiere 15 a 20 casos, y 40 a 50 para una base confiable, priorizando diversidad de inputs por sobre volumen. La razón de usar binarias y no un score 1 a 10 es que son deterministas: mismo input, mismo resultado, sin necesidad de una segunda llamada a un LLM para arbitrar. Más sobre el skill-creator en tessl.io y el catálogo completo en 50 Claude Skills 2026.
¿Qué diferencia hay entre un judge basado en reglas y un LLM-judge, y cómo se fija un umbral de pass/fail?
Un judge basado en reglas corre código determinista (regex, largos mínimos, URLs válidas) y siempre da el mismo resultado; un LLM-judge lee el contenido y puntúa criterios subjetivos como el ángulo o la profundidad del gap, con algo de varianza entre corridas. Un sesgo conocido de los LLM-judges es que puntúan mejor las respuestas más largas aunque tengan la misma calidad, según Galtea, y la documentación de Promptfoo permite fijar un threshold mínimo sobre el score 0 a 1 que devuelve el LLM. La combinación que funciona en producción es hard checks de reglas primero (bloquean rápido y gratis) y recién si pasan esos, un rubric semántico con LLM-judge y un piso mínimo por eje, no un promedio total que puede tapar un eje débil.
¿Cómo se mitiga la varianza entre corridas de un LLM-judge antes de fijarlo como gate de publicación?
Corriendo el mismo brief varias veces contra el judge y exigiendo acuerdo entre corridas antes de tratarlo como gate definitivo, en vez de confiar en una sola pasada. El eval de dbt de rmoff.net documenta esto de forma honesta: su rúbrica de 9 criterios en escala 0 a 3 reconoce varianza entre jueces y no resuelve un umbral fijo. La práctica que sí funciona es tratar el resultado como un test compuesto, no un score único: combinar varios criterios (intent, gap, evidencia) y exigir que cada uno supere su propio piso, más una revisión humana periódica del juez para detectar cuándo se desvía. Fijar el gate sobre un solo run de un LLM-judge sin ese chequeo es apostar a que no hubo un día de mala suerte en el sampling.
¿Qué debe incluir el unique take de un brief SEO para que no sea una afirmación genérica?
Tiene que anclarse a algo que la competencia no pueda replicar sin acceso a los mismos datos: código propio, analítica propietaria de la marca o un ángulo verificado con evidencia externa, no solo "somos más completos". El artículo de Ahrefs sobre Claude Skills cubre la librería de skills de marketing (gap de contenido, brand sentiment) pero no explica cómo blindar ese take contra la generalidad. Un unique take fuerte cita su propia prueba (por ejemplo, un script que cualquiera puede correr y verificar) y un dato real de Search Console o analytics de la marca, no una promesa sin fuente. Mirá cómo se arma un catálogo evaluado de skills en las mejores Claude Skills 2026.
¿Cuál es el riesgo de bloquear un brief válido (falso positivo) al sumar un gate semántico automático?
El riesgo real es que un rubric mal calibrado rechace un brief bueno porque un solo eje quedó débil por una razón menor, no porque el brief sea malo. Se mitiga puntuando cada eje por separado (si el juez puntúa todo junto, el primer eje contamina a los demás, según Galtea) y con un piso por eje bajo pero real (16 sobre 20, no 19) combinado con un total mínimo más alto (85), de forma que un brief flojo en un solo punto pueda repararse ahí puntualmente en vez de reescribirse entero. El costo de mantenimiento se controla versionando la rúbrica junto al código del gate y corriendo un test suite fijo (fixtures good/bad) cada vez que se toca un check, para confirmar que el piso sigue bloqueando lo que tiene que bloquear sin volverse más estricto de lo pensado.
¿Cómo se declara en un brief que Google Search Console no tiene histórico para una query, sin inventar datos?
Declarando el estado real de la fuente en el brief: used cuando hay datos y fecha de consulta, unavailable cuando la integración no está instalada o no hay filas, y not_applicable cuando la fuente no aplica al caso. Nunca se completa con un número estimado disfrazado de real. Un used legítimo detalla qué filas de Search Console se incluyeron, cuáles se excluyeron y por qué (por ejemplo, búsquedas genéricas que no mencionan la herramienta de la que habla la guía). Ese nivel de detalle es lo que separa una fuente used legítima de un número inventado que suena parecido.
Fuentes e inspiración
Un envío al mes con guías de Claude, prompts y automatización. Cero spam.